视频提示词是一份镜头说明,不是形容词清单
“电影感、唯美、震撼”可以提示氛围,却没有交代谁在动、画面发生什么变化、摄影机走向哪里,以及镜头何时结束。模型只能自行补全这些关键决策。有效的视频提示词会写出可观察的事件和时间方向。它不能保证一次生成成功,但能让目标画面更容易被生成、检查和修改。
视频提示词的核心是时间,而不只是画面
图片提示词描述的是一张完成的构图;视频提示词还要连接起点与终点:主体做什么、动作按什么顺序发生、节奏如何、摄影机怎样移动、环境怎样响应。“一个女人站在窗边”只是一帧画面;“她听见敲门声,转向门口,随后走出窗边的光区,摄影机缓缓跟随”才是一条镜头。动作有了因果,画面就更不容易变成一串漂亮却不相干的瞬间。
写清关键决策,减少反复抽卡
当动作和景别没有说清,模型可能生成多种看似合理的结果,但真正服务剧情的也许只有一种。先写主体、可见动作、场景、景别和一个有目的的运镜;声音重要时,再写对白或音效及其出现时机。这样可以缩小结果范围,也能明确判断成片哪里符合要求、哪里需要重做。提示词不是越长越好:与主要动作争夺注意力的细节,反而会让指令变模糊。
同一镜头,模糊写法与可执行写法
模糊写法:“雨夜城市里,一位侦探,电影感、悬疑。”可执行写法:“6 秒中景,夜晚的雨中公交站。侦探发现长椅下的红色信封,蹲下拾起。她读到信封上的名字时,摄影机缓慢推近,表情从好奇转为惊讶。深色外套和红色信封始终保持可见。能听见雨声与远处车流声,没有对白。”后者写明了事件、时长、景别、运镜、连续性锚点和声音。具体细节仍要根据所用模型和输入方式调整。
参考图负责“长什么样”,提示词负责“怎样变化”
图生视频时,输入图已经提供了人物外观、构图和部分光线信息。把图上每个细节重复一遍,既占用描述空间,也可能产生互相冲突的指令。提示词应补充静帧表达不了的内容:谁开始行动、哪些元素保持不变、镜头怎样移动、最后停在什么状态。人物身份或关键道具必须稳定时,把它们写成连续性要求。如果工具支持首尾帧,就让画面约束起点和终点,用文字交代中间的运动路径。
跨镜头一致性,要在生成前写进共同依据
一条好看的视频不等于一段连贯的故事。连续镜头应沿用相同的角色与场景参考、服装锚点、道具名称和运动方向,再为当前镜头补充它独有的动作。这样就把稳定身份与临时表演分开,也更容易发现服装突然变化或行进方向颠倒。文字本身未必能完全锁定人物,参考素材、统一镜头记录和人工审片仍然重要。
优化提示词时,一次只改一个关键变量
样片不符合预期时,先判断失败的是人物身份、动作顺序、运镜、时长还是声音。保留已经有效的描述和参考资产,一次只调整一项主要指令。例如动作正确、镜头却乱飘,就先简化运镜要求,不必同时重写人物与场景。记录每次使用的提示词、模型、设置和结果,重试才会成为有依据的小实验,而不是反复花钱碰运气。
先确定分镜,再写提示词
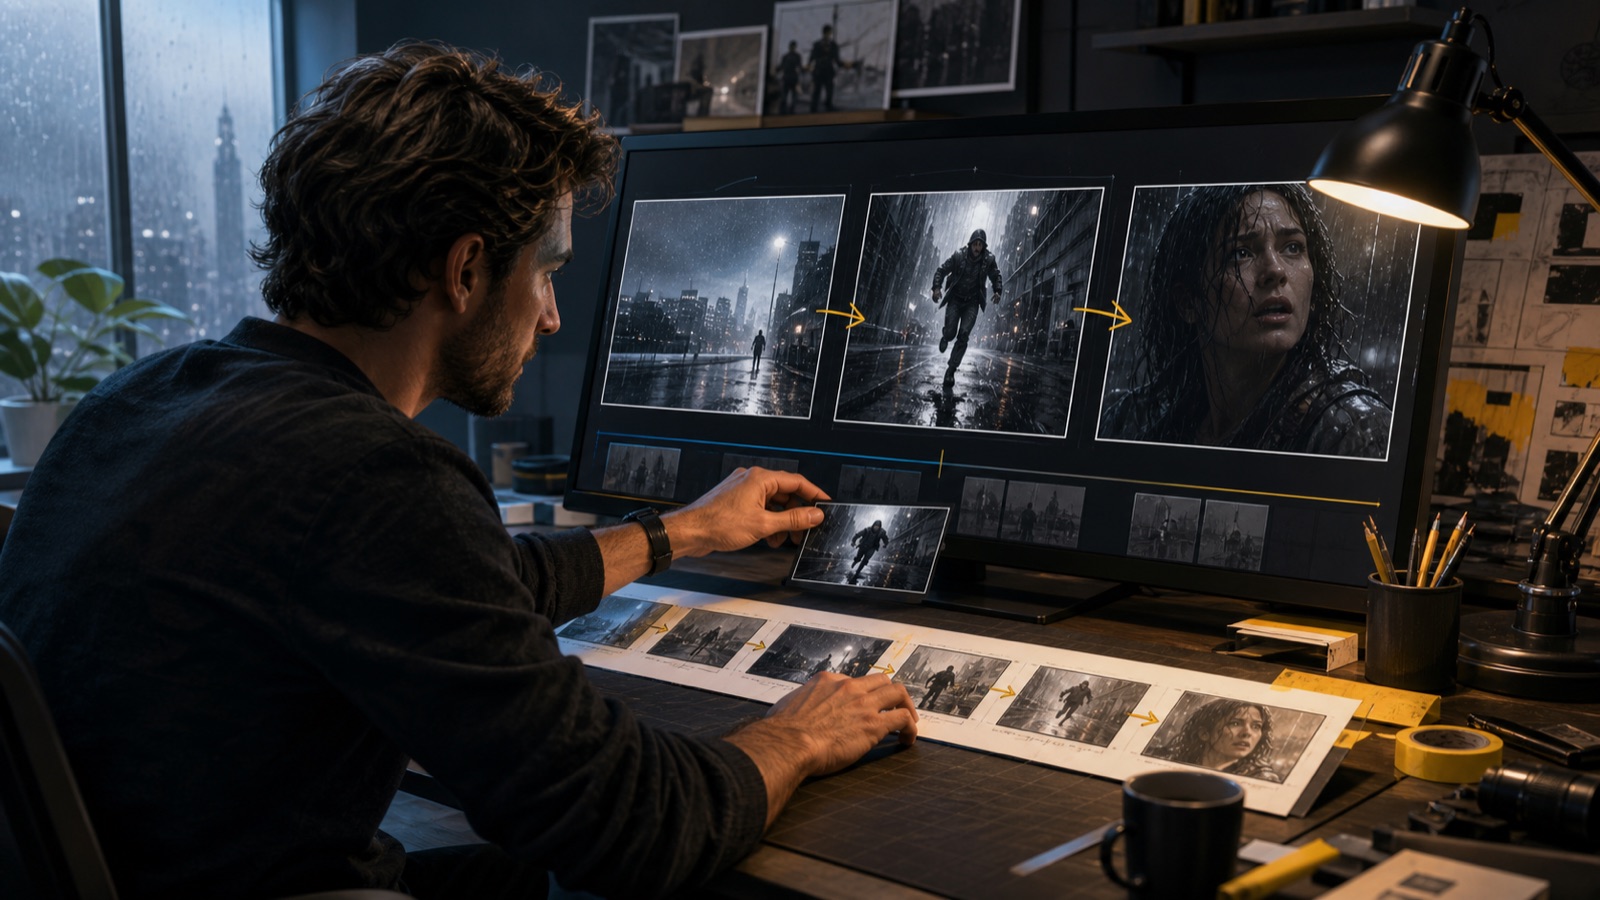
可以按这个顺序写:时长与景别 → 主体与场景 → 起始状态 → 按顺序发生的动作 → 运镜 → 结束状态 → 声音与连续性要求。只填会影响当前镜头的内容。生成前再问两件事:这条镜头是否只有一个主要任务?结尾能否接上下一镜?在 StoryToShot 中,把动作、时长、资产与提示词放在同一条分镜记录里,剧情发生变化时就能先修正视频指令,再花钱生成。